n8n AI: zo bouw je AI-stappen en agents in n8n, met drie geteste voorbeelden
AI in n8n zijn nodes die een taalmodel aanroepen: één vraag met één antwoord (een LLM-chain) of een agent die zelf gereedschap kiest. Het model zelf koppel je erbij, van een aanbieder of lokaal op je eigen computer. We bouwden drie AI-workflows van eenvoudig naar agent en testten ze met een klein lokaal model. De belangrijkste les: laat het model lezen en formuleren, en laat rekenwerk aan gewone code over. Onze agent ging daarmee van 4 naar 6 goede antwoorden op 6 vragen.
Zelf getest op 11 november 2026.
Welke AI-nodes n8n heeft
Een AI-stap in n8n bestaat uit een hoofdnode en een chatmodel dat eronder hangt. In n8n 2.47.3 telden we 20 chatmodel-nodes, onder meer voor OpenAI, Anthropic, Google Gemini, Mistral, DeepSeek, Groq, OpenRouter en Ollama (voor een model op je eigen computer).
| Node | Wat hij doet | Wanneer je hem kiest |
|---|---|---|
| Basic LLM Chain | Eén opdracht naar het model, één antwoord terug | Samenvatten, herschrijven, één woord kiezen |
| Text Classifier | Kiest een categorie uit je lijst | Sorteren, met een vangnet erachter (zie voorbeeld 2) |
| Information Extractor | Haalt velden uit vrije tekst | Naam, datum of bedrag uit een mail halen |
| AI Agent | Model dat zelf gereedschap aanroept tot het een antwoord heeft | Vragen waarbij het model eerst iets moet opzoeken |
| Tools | Gereedschap voor de agent: een tabel, een andere workflow, een MCP-server | Alles wat de agent moet kunnen lezen of doen |
| Memory | Onthoudt het gesprek | Chatbots met meerdere beurten |
Wat je nodig hebt
- n8n, zelf gehost of in de cloud. Wij testten op n8n 2.47.3, zelf gehost met Docker.
- Een chatmodel. Bij een aanbieder maak je een API-sleutel aan en vul je die in bij de chatmodel-node. Wij gebruikten qwen2.5:7b via Ollama op een gewone pc met een GTX 1660 Ti, zodat we geen sleutel nodig hadden.
- Voor voorbeeld 1 en 2 een mailaccount met IMAP; voor voorbeeld 3 twee tabellen met offertes en facturen.
Voorbeeld 1: inkomende mail samenvatten
Trigger: Email Trigger (IMAP)
Leest nieuwe mail uit je inbox en markeert hem als gelezen. Komen er meerdere tegelijk binnen, dan verwerkt n8n ze in één uitvoering.
Basic LLM Chain met een vaste opdracht
Geef het model een strakke vorm: *Kern: wat de afzender wil* en *Actie: wat je zelf moet doen*. Zet erbij dat het niets mag verzinnen. Hang de chatmodel-node eronder.
Send Email naar jezelf
Stuurt de twee regels met het onderwerp van de oorspronkelijke mail. Vervang dit door Slack of Teams als je daar liever leest.
In de test kwamen vijf klantmails binnen in één uitvoering van 11 seconden. De kern klopte bij alle vijf. De actieregel niet: bij vier van de vijf schreef het kleine model *Actie: geen*, terwijl de klant iets vroeg, zoals een monteur die naar een klemmend deurtje komt kijken. Voor deze stap is een sterker model nodig, of je laat de actieregel weg. Sjabloon: 04-mail-samenvatten.json.
Voorbeeld 2: mail sorteren met een vangnet
Hier kiest het model één categorie uit negen. Mails van vaste afzenders, zoals je leveranciers, sorteert een gewone regel; alleen de rest gaat naar het model. Een codestap controleert het antwoord, en alles wat niet op de lijst staat, gaat naar een mens. Op 50 testmails gaf dat 48 goed, 2 naar een mens en geen fouten, twee keer achter elkaar. De standaard Text Classifier-node viel in onze test af: één onleesbaar antwoord liet een hele partij van 38 mails mislukken, en in een andere run verdween één mail zonder melding. De vergelijking staat in ons stuk over AI-automatisering. Sjabloon: 05-mail-sorteren-regel-eerst.json.
Voorbeeld 3: een agent die je administratie bevraagt
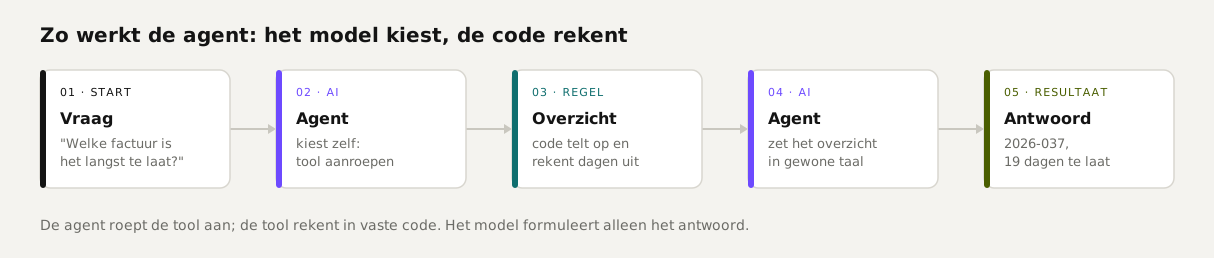
De agent krijgt een vraag als *Welke factuur is het langst te laat?* en zoekt het antwoord zelf op. We stelden zes vragen waarvan we het antwoord vooraf kenden, waaronder één die niet te beantwoorden was: het telefoonnummer van een klant, dat nergens staat. We bouwden drie versies.
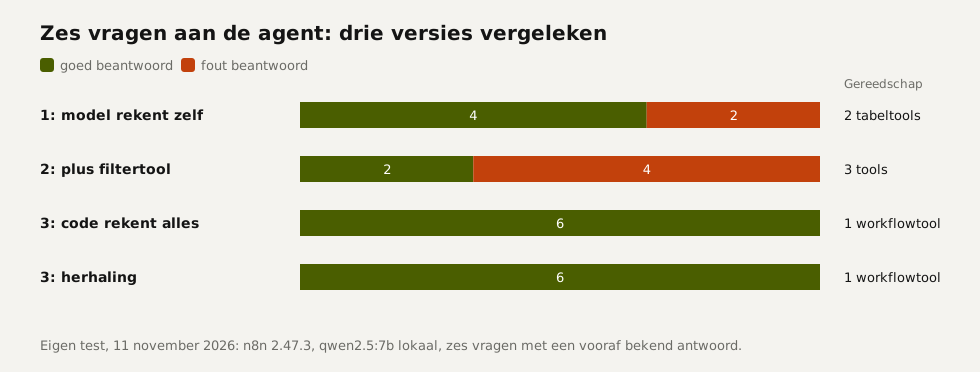
- Versie 1: twee tools die de tabellen met facturen en offertes teruggeven; het model rekent zelf. Bij de vraag of een klant nog iets openstond, keek het alleen naar facturen en miste het een open offerte. Bij *het langst te laat* koos het een factuur die nog niet eens vervallen was.
- Versie 2: een extra tool die alleen te late facturen geeft. Die vraag ging nu goed, maar het model telde 363 en 605 op tot 1.068 en noemde een verzonnen e-mailadres bij de telefoonvraag.
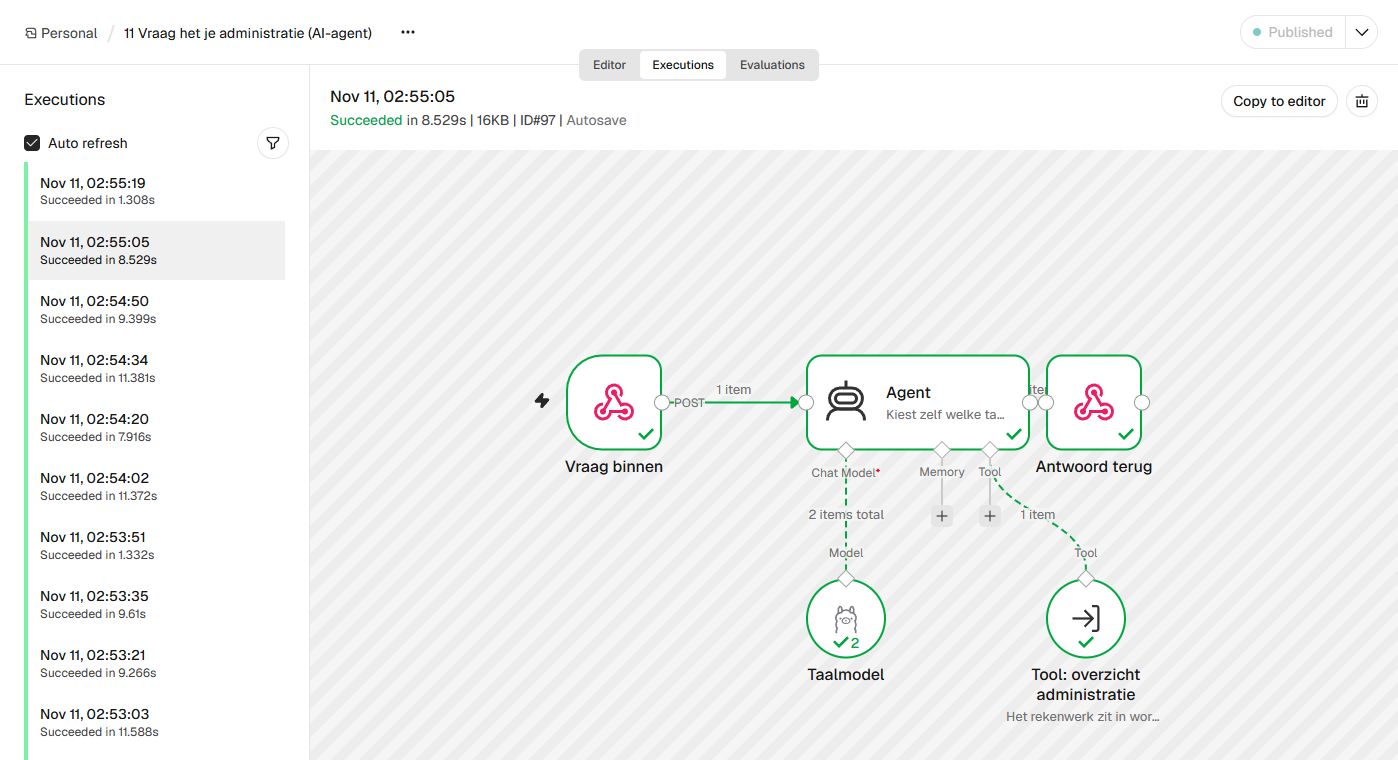
- Versie 3: één tool, en dat is een kleine n8n-workflow die beide tabellen leest en in een Code-node alles uitrekent: totalen, dagen te laat, wat er per klant openstaat. Het model zet dat overzicht alleen in gewone taal. Zes van de zes goed, en bij herhaling weer.
 (opent op ware grootte)
Eén ding om op te letten: bij de telefoonvraag riep het model de tool niet eens aan. Het antwoord was goed, maar het had het overzicht niet bekeken. De agent-node heeft in n8n 2.47.3 een optie die een eerste toolaanroep afdwingt (forceToolCallOnFirstIteration); die hebben we nog niet getest. Sjablonen: 11-vraag-het-je-administratie-agent.json en de hulpworkflow 12-overzicht-administratie-hulp.json.
Wat een AI-run in n8n kost
n8n laat per uitvoering zien hoeveel tokens het model las en schreef (een token is ongeveer een lettergreep). Dit zijn onze gemiddelden, omgerekend met de officiële prijzen van drie modellen. Elk model telt tokens iets anders, dus zie het als orde van grootte.
| Workflow | Tokens in / uit per run | Claude Haiku 5.5 | Gemini 3.1 Flash-Lite | Claude Sonnet 5.5 |
|---|---|---|---|---|
| Mail samenvatten | 112 / 21 | $0,02 per 1.000 | $0,06 per 1.000 | $0,43 per 1.000 |
| Mail sorteren | 243 / 3 | $0,03 per 1.000 | $0,07 per 1.000 | $0,52 per 1.000 |
| Agent, per vraag | 920 / 50, twee modelaanroepen | $0,12 per 1.000 | $0,30 per 1.000 | $2,34 per 1.000 |
Een agent kost per vraag zo'n acht keer zoveel tokens als een samenvatting, omdat het model twee keer meedenkt en het hele overzicht leest. Met een lokaal model betaal je niets per run, maar je wacht langer: de agent deed er bij ons 8 tot 13 seconden over per vraag.
AI-agents in n8n of in Python?
Bouw in n8n als je agent vooral bestaande apps moet aanroepen, als iemand zonder programmeerkennis hem moet kunnen aanpassen, of als er een goedkeuringsstap in zit. Elke stap is zichtbaar en elke uitvoering blijft bewaard. Kies code als de logica zelf ingewikkeld is, als je tests en versiebeheer per regel wilt, of als de agent lang zelfstandig doorwerkt. Wij gebruiken beide: n8n voor de koppelingen, code voor het rekenwerk, zoals voorbeeld 3 laat zien.
Een kant-en-klare workflow importeren
Klik in een nieuwe workflow op de drie puntjes naast de naam en kies Import en dan From file. Daarna koppel je je mailaccount en je eigen chatmodel. Alle sjablonen, ook die zonder AI, staan bij onze tien geteste n8n-workflows.
Vragen
Wat is n8n en wat zijn de belangrijkste functies?
n8n is een platform om workflows te bouwen die zelf werk doen tussen je apps. Voor AI heeft het nodes voor één vraag aan een model, voor sorteren en uitlezen van tekst, en voor agents die zelf gereedschap gebruiken.
Hoe bouw je je eerste workflow met een AI-stap in n8n?
Begin met een trigger, zoals nieuwe mail, en zet er een Basic LLM Chain achter met een strakke opdracht. Hang er een chatmodel onder en stuur het resultaat naar jezelf. Of importeer ons sjabloon voor mail samenvatten.
Bouw je AI-agents beter in n8n of in Python?
n8n past bij agents die apps aanroepen en zichtbaar moeten zijn voor collega's. Python past bij ingewikkelde logica en lange zelfstandige taken. Je kunt ze combineren.
Welke AI-modellen kun je in n8n gebruiken, en wat kost een run?
In n8n 2.47.3 zitten 20 chatmodel-nodes, waaronder OpenAI, Anthropic, Gemini, Mistral en Ollama voor lokale modellen. Een samenvatting kostte in onze meting met een klein model ongeveer $0,02 per 1.000 mails; een agentvraag ongeveer $0,12 per 1.000.
Hoe importeer je een kant-en-klare workflow?
Kies in een nieuwe workflow de drie puntjes naast de naam, dan Import en From file of From URL. Koppel daarna je eigen accounts.
Bronnen
- n8n Docs: Integrate AI gecontroleerd op
- n8n Docs: What agents do gecontroleerd op
- n8n Docs: Ollama Chat Model gecontroleerd op
- Anthropic: Pricing gecontroleerd op
- Google Gemini API: Pricing gecontroleerd op
- n8n Docs gecontroleerd op
Meer over automatiseringsrecepten
- Wat is n8n? Uitleg voor ondernemers, met kosten en drie workflowsn8n uitgelegd voor ondernemers: wat het doet, wat het kost in de cloud of op je eigen server, en drie workflows die we testten en die je kunt importeren.
- AI-automatisering: wanneer een regel genoeg is en wanneer je AI nodig hebtWanneer een vaste regel genoeg is en wanneer je AI nodig hebt, met onze test op 50 mails en wat het per 1.000 berichten kost.
- n8n-workflows en templates voor een klein bedrijf: tien stuks, allemaal getestTien n8n-workflows die we bouwden en testten: offerte-opvolging, betalingsherinnering, aanvraagformulier, mail sorteren en meer. Gratis te downloaden.
- Een n8n AI-agent die je mail sorteert en antwoorden voorbereidt, met akkoord vóór verzendenEen n8n AI-agent die mail sorteert en concept-antwoorden klaarzet, met je akkoord vóór verzenden. Getest op 50 mails, met de uitkomst per concept.
Ook handig
- n8n zelf hosten met Docker: installeren, back-ups maken en veilig bijwerkenn8n op je eigen server met Docker Compose, PostgreSQL en automatische HTTPS. Met een getest back-upscript, de updateroute en wat het per maand kost.
- n8n en MCP: je workflows als gereedschap voor een AI-app, en n8n als MCP-clientZo maak je van n8n een MCP-server voor Claude, ChatGPT of je eigen agent, en zo gebruikt n8n zelf een MCP-server. Getest, met sjablonen.
- AI-agents voor bedrijven in Nederland: welke taken je uitbesteedt, wat ze per maand kosten en wat je zelf houdtWelke taken een AI-agent in een klein bedrijf goed doet, wat elke taak per maand kost in onze eigen opzet, en vijf dingen die we nooit uit handen geven.