Claude-modellen vergeleken: welk model kies je voor welke taak?
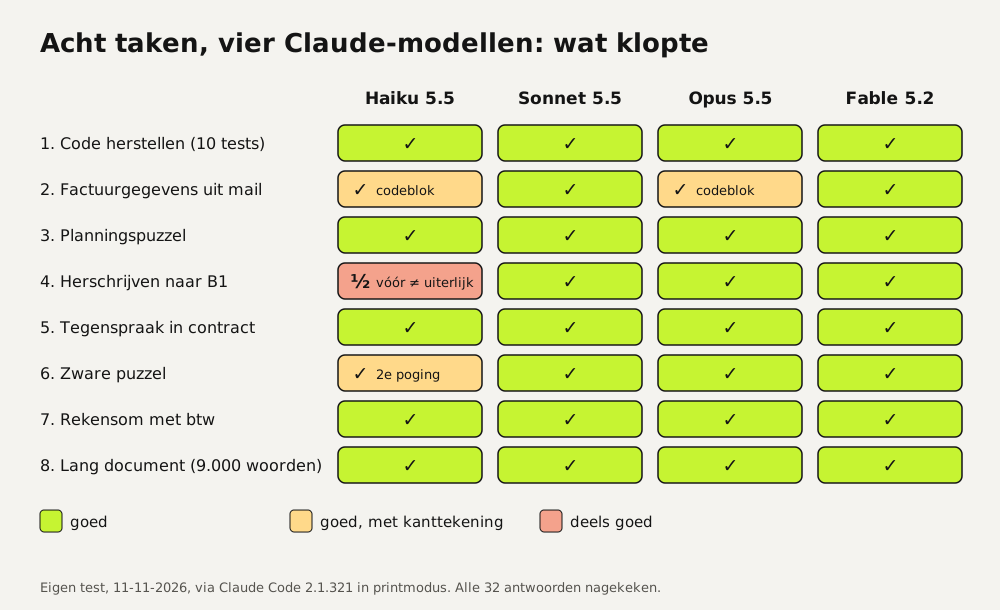
Claude heeft nu vier modellen voor dagelijks gebruik: Haiku 5.5, Sonnet 5.5, Opus 5.5 en Fable 5.2, het sterkste. Wij gaven ze op 11 november 2026 dezelfde acht taken met vaste, controleerbare antwoorden. Alle vier hadden alle acht goed. Het verschil zat in de prijs en in de details: Haiku deed de vijf dagelijkse taken voor $0,003 samen, Fable voor $0,20. Voor alledaags kantoorwerk is Sonnet dus ruim genoeg en voor veel herhaalwerk is Haiku het proberen waard. Hieronder staan de uitkomsten per taak, de kosten in euro's, wat Claude Mythos is en welk model in welk abonnement zit.
Zelf getest op 11 november 2026.
Welke Claude-modellen er zijn
| Model | Waarvoor (volgens Anthropic) | API-prijs invoer / uitvoer | In welk abonnement |
|---|---|---|---|
| Haiku 5.5 | Veel kleine taken snel: sorteren, gegevens uit tekst halen, doorsturen | Vanaf $0,10 / $0,50 | Free en hoger |
| Sonnet 5.5 | De beste mix van snelheid en intelligentie | $2 / $10 | Free en hoger |
| Opus 5.5 | Lange programmeertaken en kenniswerk; het startpunt dat Anthropic aanraadt | $4 / $20 | Pro en hoger |
| Fable 5.2 | Zwaar redeneerwerk en agents die lang doorwerken | $8 / $40 | Pro met los betaald tegoed; Max en Ultra tot de helft van de weeklimiet |
Alle vier lezen tekst en afbeeldingen, kunnen tools gebruiken en kunnen tot 1 miljoen tokens tegelijk overzien. Dat contextvenster is de hoeveelheid tekst die het model in één keer kan meenemen, genoeg voor een paar duizend pagina's. Ook de kennisgrens is gelijk: juni 2026. Wat ze onderscheidt, is snelheid, prijs en hoe ver ze komen met moeilijk werk.
Wat is Claude Mythos?
Claude Mythos is geen vijfde model voor gewone gebruikers. Volgens Anthropic zijn Mythos 5.2 en Fable 5.2 hetzelfde onderliggende model. Mythos is de versie zonder de extra beveiligingen voor cybersecurity- en biologieonderzoek. Je krijgt er alleen toegang toe als gecontroleerde organisatie, via een verificatieprogramma van Anthropic. Mythos 5.2 kwam op 9 november 2026 uit en kost vanaf $8 per miljoen invoertokens en $40 per miljoen uitvoertokens, net als Fable. Ben je geen beveiligingsteam of lab, dan is Fable de versie die je kunt gebruiken.
Zo hebben we getest
We gaven elk model dezelfde opdrachten via Claude Code 2.1.321 in printmodus (claude -p), zonder tools en zonder eigen instellingen, op een Linux-machine. Elke taak had een antwoord dat we konden narekenen. Kosten en tijd komen uit wat Claude Code per aanroep rapporteert; de kosten zijn berekend tegen de API-tarieven en tellen ook de vaste instructie van Claude Code mee.
- Code herstellen: een Python-functie die werkdagen telt, met een fout in de einddatum en zonder Koningsdag. Nagekeken met tien tests.
- Factuurgegevens uit een mail halen: met een valkuil. De mail noemt eerst € 1.420 en corrigeert dat daarna naar € 1.240.
- Planningspuzzel: vijf klanten over vijf dagen met zeven voorwaarden en maar één goede indeling.
- Herschrijven naar B1: een ambtelijke alinea in hooguit 70 woorden, met alle feiten erin.
- Tegenspraak in een contract: een overeenkomst van 13 artikelen met twee bepalingen die botsen.
- Zware puzzel: vijf collega's met dag, afdeling en programma uit elf aanwijzingen.
- Rekensom: staffelkorting, een kortingscode, gratis verzending en een retour, met de btw.
- Lang document: in 9.000 woorden notulen van 40 overleggen het definitieve websitebudget vinden, tussen drie eerdere besluiten en een ander project met een eigen budget.
De uitkomsten per taak
| Taak | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.2 |
|---|---|---|---|---|
| 1. Code herstellen | Goed | Goed | Goed | Goed |
| 2. Factuurgegevens | Goed (JSON in een codeblok) | Goed | Goed (JSON in een codeblok) | Goed |
| 3. Planningspuzzel | Goed | Goed | Goed | Goed |
| 4. B1-tekst | Deels: 'uiterlijk 31 januari' werd 'vóór 31 januari' | Goed | Goed | Goed |
| 5. Contract | Goed | Goed | Goed | Goed |
| 6. Zware puzzel | Goed bij de tweede poging | Goed | Goed | Goed |
| 7. Rekensom | Goed | Goed | Goed | Goed |
| 8. Lang document | Goed | Goed | Goed | Goed |
Twee dingen vielen op bij Haiku. In de B1-tekst schreef het 'vóór 31 januari' waar de brontekst 'uiterlijk 31 januari' zei. Dat lijkt klein, maar het schuift de uiterste datum een dag op, en zo'n fout zie je bij snel nalezen over het hoofd. Bij de zware puzzel bleef de eerste aanroep na tien minuten nog zonder antwoord. We hebben hem toen afgebroken. De tweede poging gaf binnen 10 seconden de goede indeling.
Bij de factuurtaak vroegen we om alleen JSON. Haiku en Opus zetten de JSON in een codeblok, Sonnet en Fable niet. Voor een mens maakt dat niets uit, voor een script dat de uitkomst direct inleest wel. Gebruik je een model in een automatisering, controleer dan altijd het formaat voordat je de uitkomst verder gebruikt.
De B1-teksten van Opus en Fable lazen het prettigst: een vraag als opening en de drie mee te sturen stukken als lijstje. Sonnet bleef dichter bij de brontekst, met woorden als 'dien in'. Dat is een smaakverschil, geen fout.
Wat de modellen kostten per taak, in euro's
| Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.2 | |
|---|---|---|---|---|
| Vijf dagelijkse taken samen | $0,003 (€0,003) | $0,040 (€0,036) | $0,102 (€0,091) | $0,203 (€0,181) |
| Gemiddeld per dagelijkse taak | €0,0005 | €0,007 | €0,018 | €0,036 |
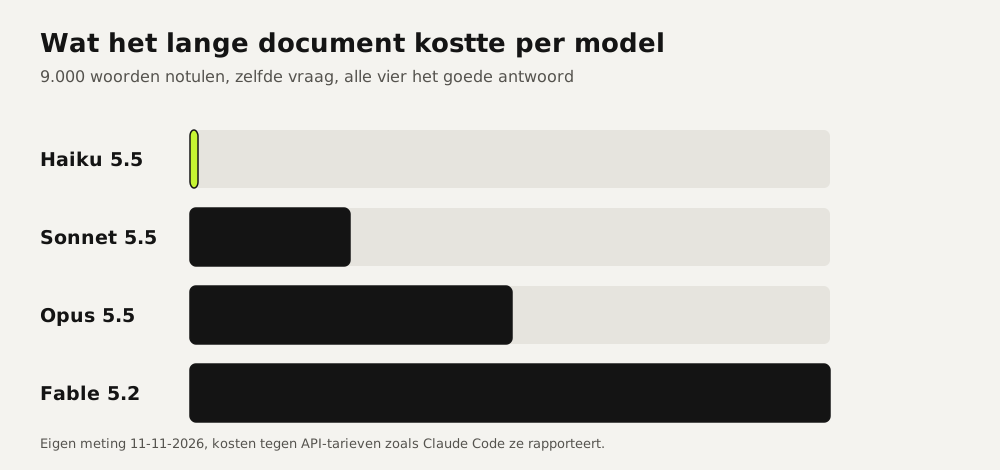
| Lang document (9.000 woorden) | $0,006 (€0,005) | $0,114 (€0,102) | $0,230 (€0,205) | $0,457 (€0,407) |
| Tijd per taak | 1,6 tot 10 seconden | 1,3 tot 6,5 seconden | 2 tot 8,5 seconden | 1,8 tot 5,7 seconden |
Bij het lange document was Sonnet twintig keer zo duur als Haiku en Fable vier keer zo duur als Sonnet. Wie duizenden mails of documenten laat verwerken, merkt dat verschil direct op de rekening.
Werk je met een abonnement zoals Pro of Max, dan betaal je niet per taak. Het verschil zit dan in je limiet: een zwaarder model gebruikt je ruimte sneller op. Wat de abonnementen kosten en welke modellen erin zitten, staat op onze pagina met alle Claude-prijzen en abonnementen.
Welk model voor welke taak
- Haiku 5.5: gegevens uit mails en formulieren halen, berichten sorteren, korte antwoorden en het doorzoeken van lange stukken waar het antwoord woord voor woord in staat. Laat een mens of een controle meekijken bij tekst die naar buiten gaat.
- Sonnet 5.5: het standaardmodel voor dagelijks werk: mails, samenvattingen, rekenwerk, code. In onze test deed het alles goed, het snelst van de vier.
- Opus 5.5: teksten die iemand anders leest en lange taken met veel stappen. Anthropic raadt het aan als startpunt voor de meeste toepassingen via de API.
- Fable 5.2: het zwaarste denkwerk en agents die uren zelfstandig doorwerken. Op onze acht taken leverde het niets op wat Sonnet niet ook kon; het meerwerk zit in langere en moeilijkere opdrachten dan wij hier gaven.
Is Opus slimmer dan Sonnet? Op onze set zagen we geen verschil in juistheid, wel in schrijfstijl en prijs. Anthropic publiceert eigen cijfers waarin Fable 5.2 en Opus 5.5 vooral voorlopen bij lange programmeertaken, zoals FrontierSWE v2: 69,9 procent voor Fable 5.2 en 62,3 procent voor Opus 5.5. Merk je bij je eigen werk niets van dat verschil, kies dan het goedkopere model.
Zelf testen met je eigen taak
De beste vergelijking doe je met je eigen werk. Heb je Claude Code, dan zie je met dit commando per model het antwoord, de duur en de kosten tegen API-tarieven. Vervang de tekst tussen de aanhalingstekens door een taak uit je eigen praktijk en draai het per model.
claude -p "Haal factuurnummer, bedrag en vervaldatum uit deze mail: ..." \
  --model claude-haiku-5-5 --output-format json --tools ""
In de JSON-uitvoer staan result (het antwoord), duration_ms (de duur) en total_cost_usd (de kosten).
Wij hebben geen betaalde relatie met Anthropic. We herhalen deze test bij elk nieuw model en zetten de nieuwe uitkomsten met datum op deze pagina.
Vragen
Wat is het nieuwste Claude-model?
Fable 5.2, sinds 9 november 2026 het standaard Fable-model in Claude Code. Ook actueel zijn Opus 5.5, Sonnet 5.5 en Haiku 5.5. Mythos 5.2 verscheen dezelfde dag, maar alleen voor gecontroleerde organisaties.
Welk model krijg je in de gratis versie, Pro en Max?
Free heeft Sonnet en Haiku. Pro voegt Opus toe en Fable met los betaald tegoed. Bij Max en Ultra mag Fable tot de helft van je weeklimiet gebruiken.
Wanneer is Haiku goed genoeg in plaats van Sonnet?
Bij taken met een duidelijk juist antwoord: gegevens uit tekst halen, sorteren, iets opzoeken in een lang document. In onze test deed Haiku dat goed voor een twintigste van de prijs van Sonnet. Voor tekst die naar klanten gaat, zagen we een betekenisfout die Sonnet niet maakte.
Is Opus slimmer dan Sonnet?
Op onze acht taken waren ze even juist. Opus schreef de B1-tekst prettiger en kostte in onze test twee tot tweeënhalf keer zoveel. Anthropic meet het verschil vooral bij lange, zware programmeertaken.
Wat kost een Claude-model per taak in euro's?
In onze test gemiddeld €0,0005 voor Haiku, €0,007 voor Sonnet, €0,018 voor Opus en €0,036 voor Fable per dagelijkse taak, tegen API-tarieven. Een lang document van 9.000 woorden kostte van €0,005 (Haiku) tot €0,41 (Fable).
Bronnen
- Claude Docs: Models overview gecontroleerd op
- Claude: Plans & pricing (modellen per abonnement en API-prijzen) gecontroleerd op
- Anthropic: Claude Mythos (beschikbaarheid, prijs en benchmarks) gecontroleerd op
- Claude Code changelog (Fable 5.2 als standaardmodel, versie 2.1.321) gecontroleerd op
Meer over prijzen en vergelijkingen
- Claude prijzen: wat elk abonnement kost en wat je ervoor krijgtWat Claude kost per plan: Free, Pro, Max, Ultra, Team en Enterprise in dollars en euro's, met wat er in 2026 veranderde en een keuzehulp.
- Claude Code kosten: abonnement, limieten en wat een klus kostClaude Code zit in Pro ($20), Max en Ultra. Wij maten vijf klussen drie keer: gemiddeld $0,28 per klus met Opus en $0,09 met Sonnet. Met rekenvoorbeeld.
- Is Claude Code gratis? Wat het kost en hoe je het goedkoopst gebruiktClaude Code installeren is gratis, gebruiken niet: je hebt een betaald abonnement of API-tegoed nodig. Wij maten wat een klus kost en testten de grens.
- Is Claude down? Zo zie je of er een storing is en wat je doetIs Claude down? Zo controleer je de officiële status in twee seconden, herken je een limiet en wat je doet. Met 90 dagen storingsgeschiedenis.
Ook handig
- Claude Desktop: downloaden, installeren en goed instellenDe Claude desktop-app voor Windows, Mac en Linux: waar je hem downloadt, wat hij kost, wat hij meer kan dan de browser en wat je na installatie instelt.
- Wat is Claude? Wat het kost en hoe goed het Nederlands schrijftClaude is de AI-assistent van Anthropic. Wat het kost in euro's, wat gratis kan en hoe goed het Nederlands schrijft: getest met zes kantoortaken.
- Wat zijn Claude Skills? Uitleg, een werkend voorbeeld en wanneer je ze gebruiktClaude Skills uitgelegd met een werkende skill die Nederlandse teksten nakijkt. Getest in Claude Code, met het verschil met CLAUDE.md, MCP en prompts.